
Заявка на демонстрацию платформы
Оставьте заявку и наш менеджер обязательно свяжется с вами ближайшее время
Принципы работы нейросетей: как устроены и обучаются нейронные сети простыми словами
Разбираем устройство нейросети, обучение на данных, основные архитектуры и причины ошибок — на понятных примерах без сложной математики.
Нейросети уже встроены в поиск, голосовых помощников, системы рекомендаций, медицину и финансовые сервисы. При этом вокруг них остается много магии: кажется, будто модель «понимает» текст или изображение так же, как человек. На практике за любым ответом стоят данные, математические операции и параметры, которые модель подбирает во время обучения. Разберем, как работает нейросеть, из чего она состоит и почему иногда ошибается.
Что такое нейронная сеть и как она работает
Нейронная сеть — это математическая модель, которая преобразует входные данные в результат с помощью набора связанных вычислительных элементов. На вход можно подать числа, пиксели изображения, аудиосигнал или последовательность слов. На выходе модель даст класс объекта, прогноз, вероятность или новый текст.
Название связано с человеческим мозгом, но сходство ограничено общей идеей: множество простых элементов объединяются и вместе обрабатывают сигнал. Искусственный нейрон не обладает сознанием и не копирует устройство человеческого мозга. Он получает числа, умножает их на числовые коэффициенты, складывает результаты и передает сигнал дальше.
Упрощенная схема работы выглядит так:
Например, задача классификации письма как спама может начинаться с набора признаков: частоты определенных слов, длины сообщения, наличия ссылок и других характеристик. Нейросеть комбинирует эти признаки и вычисляет вероятность того, что письмо относится к нужному классу.
В современных системах вход часто сложнее, чем таблица признаков. Изображение представляется матрицей значений пикселей, текст — последовательностью токенов, а звук — набором чисел, описывающих волну или спектр. Поэтому один из ключевых этапов работы нейросети — правильно представить исходные данные.
Название связано с человеческим мозгом, но сходство ограничено общей идеей: множество простых элементов объединяются и вместе обрабатывают сигнал. Искусственный нейрон не обладает сознанием и не копирует устройство человеческого мозга. Он получает числа, умножает их на числовые коэффициенты, складывает результаты и передает сигнал дальше.
Упрощенная схема работы выглядит так:
- Данные переводятся в числовое представление.
- Сигнал проходит через слои искусственных нейронов.
- Каждый слой преобразует представление данных.
- Выходной слой формирует прогноз или ответ.
Например, задача классификации письма как спама может начинаться с набора признаков: частоты определенных слов, длины сообщения, наличия ссылок и других характеристик. Нейросеть комбинирует эти признаки и вычисляет вероятность того, что письмо относится к нужному классу.
В современных системах вход часто сложнее, чем таблица признаков. Изображение представляется матрицей значений пикселей, текст — последовательностью токенов, а звук — набором чисел, описывающих волну или спектр. Поэтому один из ключевых этапов работы нейросети — правильно представить исходные данные.
Из чего состоит нейронная сеть
Давайте посмотрим на устройство нейронной сети чуть детальнее.
Искусственные нейроны, входные данные и связи
Искусственный нейрон получает несколько входных значений. Каждое значение умножается на свой вес — числовой коэффициент, который показывает, насколько этот сигнал важен для конкретного нейрона. Затем результаты складываются, к ним добавляется смещение, и полученная сумма проходит через функцию активации.
Упрощенно вычисление можно записать так:
y = f(w₁x₁ + w₂x₂ + ... + wₙxₙ + b)
Здесь x — входные данные, w — веса, b — смещение, f — функция активации, а y — выход нейрона. В большой модели таких операций могут быть миллионы или миллиарды.
Один из базовых вариантов искусственной нейронной сети — перцептрон. Он решает простую задачу классификации: получает признаки, складывает их с весами и выбирает один из вариантов ответа. Перцептрон в таком виде помогает понять принцип настройки параметров. Современные нейросети намного сложнее, но основная идея сохраняется: модель меняет коэффициенты так, чтобы нужные входы сильнее влияли на итоговый результат.
Упрощенно вычисление можно записать так:
y = f(w₁x₁ + w₂x₂ + ... + wₙxₙ + b)
Здесь x — входные данные, w — веса, b — смещение, f — функция активации, а y — выход нейрона. В большой модели таких операций могут быть миллионы или миллиарды.
Один из базовых вариантов искусственной нейронной сети — перцептрон. Он решает простую задачу классификации: получает признаки, складывает их с весами и выбирает один из вариантов ответа. Перцептрон в таком виде помогает понять принцип настройки параметров. Современные нейросети намного сложнее, но основная идея сохраняется: модель меняет коэффициенты так, чтобы нужные входы сильнее влияли на итоговый результат.
Слои нейросети: входной, скрытые и выходной
Входной слой принимает исходное числовое представление. Скрытые слои последовательно преобразуют его, а выходной слой выдает результат. Если между входом и выходом есть много слоев, говорят о глубоком обучении.
Каждый слой может извлекать признаки разного уровня. В задаче распознавания изображения первые слои реагируют на простые границы и контрасты, следующие объединяют их в фрагменты, а более глубокие слои используют эти фрагменты для распознавания форм и объектов. Это не означает, что модель заранее знает понятия «край» или «колесо»: она сама находит полезные закономерности в обучающей выборке.
Каждый слой может извлекать признаки разного уровня. В задаче распознавания изображения первые слои реагируют на простые границы и контрасты, следующие объединяют их в фрагменты, а более глубокие слои используют эти фрагменты для распознавания форм и объектов. Это не означает, что модель заранее знает понятия «край» или «колесо»: она сама находит полезные закономерности в обучающей выборке.
Чем больше слоев и параметров, тем более сложные зависимости способна выразить сеть. Но размер не гарантирует качество. Большая модель требует больше данных, вычислительных ресурсов и контроля переобучения.
Веса, смещения и функции активации
Веса и смещения — параметры нейросети. Во время обучения они изменяются. Функция активации добавляет нелинейность: без нее несколько последовательных линейных преобразований можно было бы заменить одним, и глубокая сеть не получила бы дополнительных выразительных возможностей.
На практике применяются ReLU, сигмоидальная функция, гиперболический тангенс и другие варианты. Выбор функции зависит от архитектуры и задачи. Например, ReLU часто используют в скрытых слоях, а на выходе классификатора могут применять softmax, чтобы получить оценки вероятностей для классов. Эти оценки не обязательно хорошо откалиброваны.
Важно не путать вероятность модели с гарантией. Если сеть оценивает класс с вероятностью 0,9, это означает, что при текущих параметрах и данных такой вариант получил высокий числовой балл. Это не доказательство истинности ответа и не объяснение того, почему модель пришла к выводу.
На практике применяются ReLU, сигмоидальная функция, гиперболический тангенс и другие варианты. Выбор функции зависит от архитектуры и задачи. Например, ReLU часто используют в скрытых слоях, а на выходе классификатора могут применять softmax, чтобы получить оценки вероятностей для классов. Эти оценки не обязательно хорошо откалиброваны.
Важно не путать вероятность модели с гарантией. Если сеть оценивает класс с вероятностью 0,9, это означает, что при текущих параметрах и данных такой вариант получил высокий числовой балл. Это не доказательство истинности ответа и не объяснение того, почему модель пришла к выводу.
Основные принципы работы нейросетей
У нейросетей, генерирующих изображения, пишущих тексты, выполняющих семантический поиск и анализирующих ДНК в основе лежат одни и те же принципы. Ниже рассмотрим их подробнее.

Семантический поиск по документам организации на основе ИИ (нейросети). Такой поиск реализован на платформе ECM «Анарта» (на рисунке).
Прямое распространение сигнала: как нейросеть обрабатывает информацию
Когда обученная модель получает новый объект, сигнал проходит по сети от входа к выходу. Этот этап называют прямым распространением, или forward pass. В каждом слое выполняются операции над векторами и матрицами, затем применяются функции активации.
Представим модель, которая прогнозирует спрос на товар. На вход она получает историю продаж, цену, сезон, промоактивность и другие числовые признаки. Первый слой объединяет исходные значения, следующие слои выделяют более сложные зависимости, а последний выдает прогноз спроса.
Во время обработки нейросеть не перебирает заранее написанные сценарии. Она использует параметры, которые были подобраны на примерах. Поэтому качество зависит не только от архитектуры, но и от того, насколько обучающая выборка похожа на реальные условия работы.
Представим модель, которая прогнозирует спрос на товар. На вход она получает историю продаж, цену, сезон, промоактивность и другие числовые признаки. Первый слой объединяет исходные значения, следующие слои выделяют более сложные зависимости, а последний выдает прогноз спроса.
Во время обработки нейросеть не перебирает заранее написанные сценарии. Она использует параметры, которые были подобраны на примерах. Поэтому качество зависит не только от архитектуры, но и от того, насколько обучающая выборка похожа на реальные условия работы.
Как нейросеть принимает решения и формирует ответы
Для многоклассовой классификации выходной слой обычно выдает набор чисел, после чего по правилу argmax выбирается класс с максимальной оценкой. В бинарной задаче решение часто принимают по порогу, который можно настроить с учетом цены ложного срабатывания и пропуска. Для регрессии результатом может быть одно число: прогноз выручки, температуры или времени доставки. В генерации текста модель оценивает вероятности следующих токенов и последовательно выбирает один из вариантов.
Слово «решение» здесь условно. Нейросеть не рассуждает как человек и не проверяет ответ на соответствие здравому смыслу, если такая проверка специально не заложена в систему. Она строит вычислительный прогноз на основе закономерностей, которые обнаружила в данных.
Из этого следуют два практических вывода. Во-первых, модель может находить сложные взаимосвязи, которые трудно задать вручную. Во-вторых, она способна воспроизводить перекосы обучающей выборки и выдавать уверенный, но по сути неверный результат.
Слово «решение» здесь условно. Нейросеть не рассуждает как человек и не проверяет ответ на соответствие здравому смыслу, если такая проверка специально не заложена в систему. Она строит вычислительный прогноз на основе закономерностей, которые обнаружила в данных.
Из этого следуют два практических вывода. Во-первых, модель может находить сложные взаимосвязи, которые трудно задать вручную. Во-вторых, она способна воспроизводить перекосы обучающей выборки и выдавать уверенный, но по сути неверный результат.
Пример работы нейронной сети на простой задаче
Допустим, нужно определить, стоит ли показывать клиенту персональное предложение. На вход подаются частота покупок, средний чек, давность последнего заказа и реакция на прошлые акции.
На первом слое сеть преобразует отдельные признаки. На втором может обнаружить сочетание «частые покупки плюс недавний заказ». Следующие слои сопоставляют комбинации признаков с примерами из обучающей выборки. Выходной слой формирует вероятность отклика.
Если модель получила высокую оценку, это еще не означает, что предложение обязательно сработает. Оценку нужно проверять на отложенных данных и в реальном процессе: например, сравнивать прогноз с фактической конверсией. Для бизнеса важны не только математические метрики, но и стоимость ошибки, ограничения по данным, скорость ответа и понятность интеграции с действующими системами.
На первом слое сеть преобразует отдельные признаки. На втором может обнаружить сочетание «частые покупки плюс недавний заказ». Следующие слои сопоставляют комбинации признаков с примерами из обучающей выборки. Выходной слой формирует вероятность отклика.
Если модель получила высокую оценку, это еще не означает, что предложение обязательно сработает. Оценку нужно проверять на отложенных данных и в реальном процессе: например, сравнивать прогноз с фактической конверсией. Для бизнеса важны не только математические метрики, но и стоимость ошибки, ограничения по данным, скорость ответа и понятность интеграции с действующими системами.
Как происходит обучение нейронных сетей
Обучение нейросети — это ключевой этап, наделяющий ее реальной функциональностью. Именно от объема обучения и способа, которым он выполняется, зависит итоговая мощность и возможности нейросети.
Подготовка данных и настройка параметров
Обучение начинается с набора примеров. В обучении с учителем у каждого примера есть целевой ответ: класс изображения, правильная транскрипция речи или фактическое значение спроса. Данные обычно разделяют на обучающую, валидационную и тестовую части. Первая используется для настройки весов, вторая — для выбора конфигурации, третья — для итоговой оценки.
Перед обучением данные очищают, приводят к сопоставимому масштабу и переводят в подходящий формат. Для текста выполняют токенизацию, для изображений — изменение размера и нормализацию, для таблиц — обработку пропусков и категориальных признаков. Ошибка на этом этапе может снизить качество сильнее, чем неудачный выбор архитектуры.
Перед обучением данные очищают, приводят к сопоставимому масштабу и переводят в подходящий формат. Для текста выполняют токенизацию, для изображений — изменение размера и нормализацию, для таблиц — обработку пропусков и категориальных признаков. Ошибка на этом этапе может снизить качество сильнее, чем неудачный выбор архитектуры.
Функция потерь: как нейросеть определяет ошибки
Модель сравнивает свой прогноз с правильным ответом. Функция потерь превращает разницу в число: чем хуже прогноз, тем выше значение функции потерь. Для классификации часто используют перекрестную энтропию, для прогнозирования числовых значений — среднюю квадратичную или абсолютную ошибку.
Функция потерь задает направление обучения, но не всегда совпадает с бизнес-метрикой. Например, снижение средней ошибки прогноза не гарантирует минимальных потерь от дефицита товара. Поэтому при проектировании системы важно заранее определить, какую ошибку бизнес считает критичной.
Функция потерь задает направление обучения, но не всегда совпадает с бизнес-метрикой. Например, снижение средней ошибки прогноза не гарантирует минимальных потерь от дефицита товара. Поэтому при проектировании системы важно заранее определить, какую ошибку бизнес считает критичной.
Обратное распространение ошибки и градиентный спуск
После прямого прохода модель получает значение ошибки. Затем алгоритм обратного распространения вычисляет градиенты функции потерь по параметрам: они показывают, как изменение веса повлияет на loss. Google описывает backpropagation как алгоритм, который реализует градиентный спуск в нейросетях и определяет, в какую сторону менять веса.
Дальше применяется градиентный спуск: веса немного изменяются так, чтобы в следующем цикле ошибка уменьшилась. Размер шага задает скорость обучения. Слишком большой шаг может мешать обучению, а слишком маленький делает его медленным. На практике параметры обновляются многократно, небольшими пакетами примеров.
Один цикл состоит из прямого прохода, расчета функции потерь, обратного прохода и обновления параметров. После многих итераций сеть постепенно подбирает такие веса, которые хорошо воспроизводят закономерности обучающей выборки.
Дальше применяется градиентный спуск: веса немного изменяются так, чтобы в следующем цикле ошибка уменьшилась. Размер шага задает скорость обучения. Слишком большой шаг может мешать обучению, а слишком маленький делает его медленным. На практике параметры обновляются многократно, небольшими пакетами примеров.
Один цикл состоит из прямого прохода, расчета функции потерь, обратного прохода и обновления параметров. После многих итераций сеть постепенно подбирает такие веса, которые хорошо воспроизводят закономерности обучающей выборки.
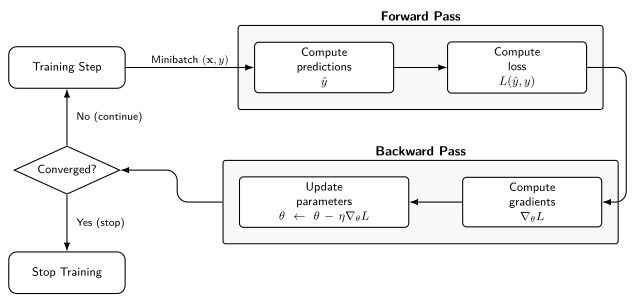
Схема цикла обучения MLP
Обучение с учителем, без учителя и с подкреплением
В обучении с учителем модель получает пары «пример — правильный ответ». Так строят классификаторы, системы распознавания речи и многие прогнозные модели.
В обучении без учителя правильные ответы заранее не заданы. Алгоритм сам ищет структуру в данных: группы похожих клиентов, аномалии или компактное представление объектов. Такой подход полезен, когда разметка данных дорогая или ее невозможно получить.
В обучении с подкреплением агент взаимодействует со средой, совершает действия и получает вознаграждение или штраф. Цель — выработать стратегию, которая увеличивает суммарное вознаграждение. Подход применяют в управлении, играх, робототехнике и задачах последовательного принятия решений.
В обучении без учителя правильные ответы заранее не заданы. Алгоритм сам ищет структуру в данных: группы похожих клиентов, аномалии или компактное представление объектов. Такой подход полезен, когда разметка данных дорогая или ее невозможно получить.
В обучении с подкреплением агент взаимодействует со средой, совершает действия и получает вознаграждение или штраф. Цель — выработать стратегию, которая увеличивает суммарное вознаграждение. Подход применяют в управлении, играх, робототехнике и задачах последовательного принятия решений.
Основные виды и архитектуры нейронных сетей
В этом разделе я коротко рассмотрю, какие бывают архитектуры нейронных сетей. Выбор архитектуры определяется решаемой задачей, но в бытовом смысле пользователю об этом думать не надо. Проектирование архитектурпы нейросетей — это задача инженеров. Здесь приводим сведения просто для общего понимания и снятия страха перед «всемогущим» искусственным интеллектом.
Полносвязные нейронные сети
В полносвязном слое каждый нейрон связан со всеми элементами предыдущего слоя. Такие сети подходят для табличных данных и относительно простых задач классификации и регрессии. Их легко объяснить на уровне формул, но при работе с изображениями или длинным текстом полносвязная архитектура быстро становится слишком тяжелой.
Свёрточные сети (CNN)
Свёрточная сеть обрабатывает локальные области изображения с помощью фильтров. Один фильтр может реагировать на границы, другой — на текстуру или более сложный фрагмент. За счет повторного применения фильтров сеть учитывает пространственную структуру данных.
CNN лежат в основе задач классификации, локализации и обнаружения объектов. Такие модели применяют в компьютерном зрении, контроле качества, медицинской визуализации и распознавании образов.
CNN лежат в основе задач классификации, локализации и обнаружения объектов. Такие модели применяют в компьютерном зрении, контроле качества, медицинской визуализации и распознавании образов.
Рекуррентные нейронные сети (RNN)
Рекуррентные сети предназначены для последовательностей. Они передают состояние от одного шага к следующему, поэтому текущий результат зависит не только от текущего входа, но и от предыдущего контекста. Это делает RNN подходящими для временных рядов, речи и текста.
У рекуррентных архитектур есть ограничения: при длинной последовательности модели сложнее сохранять дальние зависимости, а последовательная обработка затрудняет эффективное использование вычислительных ресурсов. Для части задач RNN заменили более поздние архитектуры.
У рекуррентных архитектур есть ограничения: при длинной последовательности модели сложнее сохранять дальние зависимости, а последовательная обработка затрудняет эффективное использование вычислительных ресурсов. Для части задач RNN заменили более поздние архитектуры.
Трансформеры и большие языковые модели (LLM)
Трансформер использует механизм внимания, который позволяет сопоставлять элементы последовательности и оценивать, какие из них важны друг для друга. В оригинальной работе Attention Is All You Need авторы предложили архитектуру для обработки последовательностей без рекуррентных и сверточных слоев; наряду с вниманием в ней есть позиционные представления и полносвязные слои.
Полная схема архитектуры Transformer
Трансформеры хорошо масштабируются при обучении на больших массивах текста и других данных. Большие языковые модели (LLM) — это нейросети, которые обучаются на последовательностях токенов и затем генерируют текст, выбирая следующие элементы с учетом контекста. Они могут поддерживать диалог, суммировать документы и писать код, но их ответ остается статистическим продолжением входа, а не гарантированно проверенным знанием.
Это, конечно, не значит, что LLM бесполезны. Напротив: в задачах нечеткого семантического поиска («найди договор, который мы заключали с каким-то трансопртным предприятием летом или осенью») или для поиска неочевидных закономерностей архитектура трансформера подходит как нельзя лучше. Именно поэтому нейросети часто используют, например, в документообороте или для комплексной автоматизации рутиных действий. Просто нужно осознавать ограничения технологии.
Это, конечно, не значит, что LLM бесполезны. Напротив: в задачах нечеткого семантического поиска («найди договор, который мы заключали с каким-то трансопртным предприятием летом или осенью») или для поиска неочевидных закономерностей архитектура трансформера подходит как нельзя лучше. Именно поэтому нейросети часто используют, например, в документообороте или для комплексной автоматизации рутиных действий. Просто нужно осознавать ограничения технологии.
Чем нейронные сети отличаются от искусственного интеллекта и машинного обучения
Искусственный интеллект — широкое понятие для систем, которые выполняют задачи, связанные с восприятием, анализом, планированием или генерацией. Машинное обучение — один из подходов внутри искусственного интеллекта: алгоритм находит закономерности в данных, вместо того чтобы получать все правила вручную.
Нейронные сети — класс моделей машинного обучения. Глубокое обучение — область машинного обучения, в которой используют многослойные нейронные сети. Эти понятия связаны, но не взаимозаменяемы: не всякая нейронная сеть глубокая и не все методы машинного обучения основаны на нейросетях.
Границы терминов важны на практике. Запрос «внедрить ИИ» слишком общий: для бизнеса нужно уточнить задачу, тип данных, допустимую ошибку, требования к скорости и способ проверки результата. Иногда достаточно простой модели машинного обучения, а иногда оправдана глубокая нейросеть.
Нейронные сети — класс моделей машинного обучения. Глубокое обучение — область машинного обучения, в которой используют многослойные нейронные сети. Эти понятия связаны, но не взаимозаменяемы: не всякая нейронная сеть глубокая и не все методы машинного обучения основаны на нейросетях.
Границы терминов важны на практике. Запрос «внедрить ИИ» слишком общий: для бизнеса нужно уточнить задачу, тип данных, допустимую ошибку, требования к скорости и способ проверки результата. Иногда достаточно простой модели машинного обучения, а иногда оправдана глубокая нейросеть.
Задумались о внедрении ИИ в бизнес? Оставьте заявку на консультацию.
Где применяются нейросети: примеры использования
Нейросети используют там, где есть повторяющиеся данные и закономерности, которые можно извлекать автоматически. Основные направления:
IBM приводит среди типовых применений CNN, RNN и трансформеров распознавание изображений, речи, прогнозирование, выявление мошенничества и обработку текста. Выбор архитектуры зависит от структуры данных, требований к задержке, объема обучающей выборки и цены ошибок.
- обработка естественного языка: классификация обращений, поиск по документам, генерация текста и голосовые помощники;
- компьютерное зрение: распознавание объектов, контроль дефектов, анализ медицинских изображений;
- прогнозирование: спрос, нагрузка, вероятность оттока, сроки доставки и финансовые показатели;
- распознавание речи: транскрибация звонков и управление голосом;
- обнаружение аномалий: подозрительные операции, сбои оборудования, отклонения в показаниях датчиков;
- рекомендации: подбор товаров, контента или следующего действия пользователя.
IBM приводит среди типовых применений CNN, RNN и трансформеров распознавание изображений, речи, прогнозирование, выявление мошенничества и обработку текста. Выбор архитектуры зависит от структуры данных, требований к задержке, объема обучающей выборки и цены ошибок.
Преимущества и ограничения нейронных сетей
Нейросети умеют работать с неструктурированными данными, находить нелинейные зависимости и улучшать результат при наличии новых качественных примеров. Они особенно полезны там, где правила трудно описать вручную: в изображениях, речи, тексте и сложных временных рядах.
Ограничения не менее важны. Обучение требует данных и вычислительных ресурсов. Качество может снижаться при изменении поведения пользователей, ассортимента или условий съемки. Сложные модели труднее объяснять и сопровождать, а ошибки могут быть неравномерно распределены между группами объектов.
Ограничения не менее важны. Обучение требует данных и вычислительных ресурсов. Качество может снижаться при изменении поведения пользователей, ассортимента или условий съемки. Сложные модели труднее объяснять и сопровождать, а ошибки могут быть неравномерно распределены между группами объектов.
Почему нейросети ошибаются и что такое переобучение
Переобучение (overfitting) возникает, когда модель слишком хорошо подстраивается под обучающие примеры и хуже работает на новых данных. Google определяет overfitting как ситуацию, при которой модель хорошо показывает себя на обучающей выборке, но плохо прогнозирует неизвестные примеры.
Причиной может быть слишком сложная архитектура, маленькая или нерепрезентативная выборка, утечка информации между обучением и тестом. Для борьбы применяют регуляризацию, dropout, аугментацию данных, раннюю остановку и контроль качества на отложенной выборке.
Есть и другие источники ошибок: неверная разметка, пропуски, смещение выборки, изменение распределения данных и неудачная постановка функции потерь. Модель может быть математически точной на тесте, но бесполезной в процессе, если тест не отражает реальные условия.
Причиной может быть слишком сложная архитектура, маленькая или нерепрезентативная выборка, утечка информации между обучением и тестом. Для борьбы применяют регуляризацию, dropout, аугментацию данных, раннюю остановку и контроль качества на отложенной выборке.
Есть и другие источники ошибок: неверная разметка, пропуски, смещение выборки, изменение распределения данных и неудачная постановка функции потерь. Модель может быть математически точной на тесте, но бесполезной в процессе, если тест не отражает реальные условия.
От чего зависит точность работы нейросети
На результат влияют пять групп факторов:
Поэтому вопрос «какая нейросеть самая точная» обычно поставлен неправильно. Корректнее спросить, какая модель лучше решает конкретную задачу при заданных ограничениях по данным, времени ответа, стоимости и риску ошибки.
Для практического проекта полезно начинать с формулировки результата: что именно должна предсказывать или генерировать система, кто будет использовать ответ и что произойдет при ошибке. После этого выбирают данные, метрику и архитектуру. Такой порядок помогает не превращать нейросеть в технологию ради технологии.
- Качество и полнота данных.
- Соответствие обучающей выборки реальному сценарию.
- Архитектура и размер модели.
- Настройки обучения: скорость, размер пакета, число итераций и регуляризация.
- Метрика оценки и способ внедрения в рабочий процесс.
Поэтому вопрос «какая нейросеть самая точная» обычно поставлен неправильно. Корректнее спросить, какая модель лучше решает конкретную задачу при заданных ограничениях по данным, времени ответа, стоимости и риску ошибки.
Для практического проекта полезно начинать с формулировки результата: что именно должна предсказывать или генерировать система, кто будет использовать ответ и что произойдет при ошибке. После этого выбирают данные, метрику и архитектуру. Такой порядок помогает не превращать нейросеть в технологию ради технологии.
Часто задаваемые вопросы о принципах работы нейросетей
Что такое нейросеть и как она понимает текст, изображения и речь?
Строго говоря, нейросеть не понимает данные так, как это делает человек. Она переводит текст, изображение или звук в числовое представление, а затем находит закономерности в этих числах. Текст разбивается на токены, изображение — на значения пикселей или признаки, речь — на последовательность характеристик аудиосигнала. Обученная модель использует найденные зависимости, чтобы классифицировать объект, сделать прогноз или сгенерировать продолжение. Искусственные нейроны и их связи не воспроизводят работу человеческого мозга: это математическая модель, а не цифровая копия биологической системы.
Может ли нейросеть обучаться самостоятельно?
Это зависит от постановки задачи. При обучении без учителя модель ищет структуру в данных без заранее заданных правильных ответов. При обучении с подкреплением она получает сигналы вознаграждения от среды. Но в обоих случаях нужны цель, данные, правила оценки и вычислительная процедура. Нейросеть не ставит себе бизнес-задачи и не выбирает критерии качества без участия людей.
Чем искусственный нейрон отличается от биологического?
Биологический нейрон — живая клетка, которая обменивается сигналами через сложные химические и электрические процессы. Искусственный нейрон — математическая функция, выполняющая операции над числами. Термин «нейрон» помогает объяснить идею связанных элементов, но не означает, что искусственная сеть воспроизводит человеческий мозг.
Строго говоря, нейросеть не понимает данные так, как это делает человек. Она переводит текст, изображение или звук в числовое представление, а затем находит закономерности в этих числах. Текст разбивается на токены, изображение — на значения пикселей или признаки, речь — на последовательность характеристик аудиосигнала. Обученная модель использует найденные зависимости, чтобы классифицировать объект, сделать прогноз или сгенерировать продолжение. Искусственные нейроны и их связи не воспроизводят работу человеческого мозга: это математическая модель, а не цифровая копия биологической системы.
Может ли нейросеть обучаться самостоятельно?
Это зависит от постановки задачи. При обучении без учителя модель ищет структуру в данных без заранее заданных правильных ответов. При обучении с подкреплением она получает сигналы вознаграждения от среды. Но в обоих случаях нужны цель, данные, правила оценки и вычислительная процедура. Нейросеть не ставит себе бизнес-задачи и не выбирает критерии качества без участия людей.
Чем искусственный нейрон отличается от биологического?
Биологический нейрон — живая клетка, которая обменивается сигналами через сложные химические и электрические процессы. Искусственный нейрон — математическая функция, выполняющая операции над числами. Термин «нейрон» помогает объяснить идею связанных элементов, но не означает, что искусственная сеть воспроизводит человеческий мозг.
Надеюсь, теперь вы стали чуть лучше понимать, как устроена нейросеть. В статье мы лишь коротко затронули области применения нейросетей. А они — обширны, в том числе в сфере электронного документа оборота. Если вы хотите узнать больше об использовании ИИ в документообороте предприятия, переходите по ссылке или напишите нам в «Анарта».
Остались вопросы? Оставьте заявку на консультацию.
Заявка на консультацию
Оставьте заявку и наш менеджер обязательно свяжется с вами ближайшее время